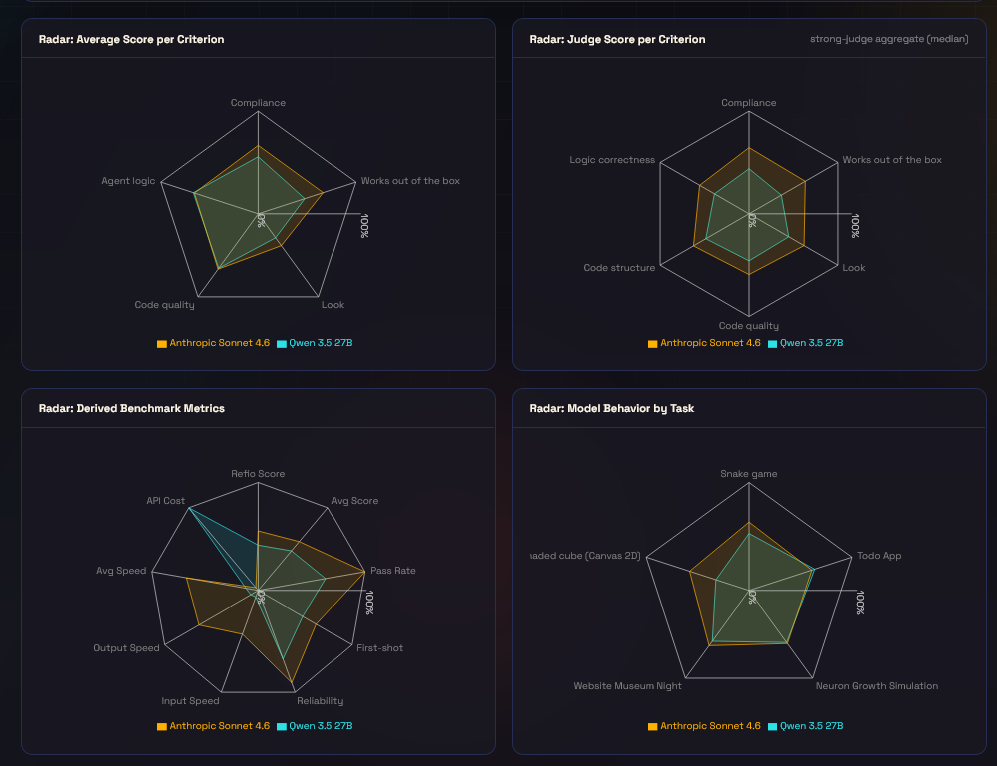
Wrzuciłem Qwen 3.8 27B do benchmarku Refio. Nie po to, żeby wyprodukować kolejną tabelkę w stylu „model X jest zaskakująco dobry”, bo tych internet ma już więcej niż poradników o porannej rutynie. Chciałem sprawdzić go tak samo jak resztę: pięć zadań, po sześć prób, ten sam silnik agentowy, którego używam w pluginie do IntelliJ.
Wynik jest mocny. Lokalny model ma zbliża się Claude Sonneta. Ale ciekawsze jest to, dlaczego w ogóle ufam tej liczbie. W tym samym czasie testy e2e Refio urosły z 20 do 102 scenariuszy i dopiero one pokazały mi, gdzie benchmark potrafił mierzyć nie model, tylko moje własne błędy.
Qwen 3.8 27B – liczby
Próby szły lokalnie na DGX Spark z 128 GB pamięci zunifikowanej. Model był w kwantyzacji Q4_K_M, zajmował około 18 GB na GPU, a dłuższe zadania miały okno kontekstu 64k. To ważne, bo bez sprzętu i ustawień porównanie modeli jest trochę jak wynik testu auta bez informacji, czy jechało po asfalcie, czy po schodach.
W benchmarku są pięć zadań, od prostszego Todo po rzeczy, na których przeglądarka potrafi dostać zadyszki. Każde leci sześć razy. Nie ma tu jednego udanego dema, z którego można zrobić heroiczny screen na Twittera, a potem nie patrzeć na pięć pozostałych prób. Jeden z wcześniejszych przypadków, czyli kod zabijający przeglądarkę, dobrze pokazał, czemu screen nie wystarcza.
Qwen 3.8 27B osiągnął 88,7% wyniku Sonneta. Sonnet nadal jest szybszy – średnio około 130 sekund na próbę wobec około 450 sekund – ale lokalny model zaliczał około 90% prób. Na moich pięciu zadaniach wyszedł też stabilniej niż Qwen 3.5 122B, choć w ogólnym wyniku oba modele są blisko siebie.
To nie jest teza, że „lokalne już wygrały”. Nie wygrały. Na większych stronach i przy dopieszczaniu wyglądu chmura nadal potrafi odjechać. Za to do jednoplikowych aplikacji i średnich zadań agentowych 27B przestało być eksperymentem, który odpala się tylko po to, żeby potem westchnąć i wrócić do API.
Wszystkie próby Qwen 3.8 oceniał ten sam aktualny sędzia. To zaznaczam, bo porównując go ze starszymi seriami trzeba pamiętać, że warstwa oceny też się zmieniała. Sędzia jest u mnie dodatkową opinią, nie wyrokiem – twardy wynik nadal ustalają pliki, build, status i limity wykonania. O tym, dlaczego nadal oceniam sam, pisałem już wcześniej.
Skąd się wzięło 102 scenariusze
Jeszcze w czerwcu miałem 20 scenariuszy e2e. We wrześniu jest ich 102. Nie dlatego, że nagle pokochałem pisanie testów. Po prostu kilka razy benchmark zwrócił wynik, który wyglądał sensownie, a potem okazywało się, że sensowny był tylko opis problemu.
Scenariusz to plik JSON: projekt startowy, prompt, tryb pracy agenta, limit iteracji i asercje. Część jest twarda: zadanie musi skończyć się statusem SUCCESS, wskazane fragmenty muszą być w pliku, chroniony plik ma zostać nietknięty, build musi przejść, a kontekst i budżet narzędzi nie mogą się wylać. Są też asercje miękkie – kolejność narzędzi i opcjonalny sędzia LLM. Te ostrzegają, ale nie są w stanie uniewinnić zepsutego builda. Samą warstwę oceny opisałem dokładniej w tekście o trójwarstwowym sędzim.
Brzmi normalnie. Dopóki nie zobaczysz, co potrafi przejść przez same testy jednostkowe.
Najpierw agent robił robotę, zapisywał poprawny plik, a potem dopisywał „to jeszcze skompiluję”. Pętla uznawała turę za niedokończoną i zaliczała porażkę. Po poprawce liczba zaliczeń na siedmiu modelach skoczyła z 33 do 45 na 49. Małe Qweny 3.5 z 5 na 7 na 7. To nie modele nagle zmądrzały. Mój agent przestał je karać za cudze błędy.
Potem wyszło, że harness w trybie headless odrzucał komendy budowania i testów przez regułę zatwierdzeń. W jednej kampanii 10 z 258 przebiegów skończyło się na odmowie, w tym 8 z już gotowym wynikiem. Kolejny klasyk: parametr --model ustawiał model tylko dla tury, więc wygenerowany plik mógł powstać w innym modelu niż ten, który rzekomo testowałem. Benchmark byłby piękny. I kompletnie o czymś innym.
Była też tura, która spaliła 1,56 mln tokenów wejścia. Normalnie mieszczę się w 50-150 tysiącach. Lokalnie rachunek wynosił 0 dolarów, więc taki wyciek łatwo przeoczyć – do chwili, gdy ten sam mechanizm trafi na model w chmurze. Stąd limity tokenów i minut na turę.
Testy muszą umieć powiedzieć „nie”
Ostatnia runda nie polegała nawet na dopisywaniu scenariuszy, tylko na psuciu ich celowo. Walidator sprawdzał kiedyś, czy poprawka trafiła do pliku. Przepuszczał więc plik ucięty w połowie, usunięty test, zahardkodowaną odpowiedź albo zmianę manifestu. Teraz katalog złych rozwiązań musi zostać odrzucony, inaczej sam walidator nie przechodzi.
To jest ten moment, w którym testy przestają być dekoracją do zielonego paska. Każda partia zapisuje commit, hash scenariuszy, dokładną wersję i kwantyzację modelu, sprzęt oraz konfigurację. „U mnie przeszło” bez tego zestawu jest zdaniem, które bardzo łatwo powiedzieć, a bardzo trudno potem odtworzyć.
Przy agencie dochodzi jeszcze niedeterminizm. Jeżeli scenariusz przechodzi w 75% prób, trzy zielone przebiegi z rzędu mają około 42% szans. Jeden przebieg nie jest dowodem, tylko anegdotą z dobrym oświetleniem. Dlatego puszczam sześć prób i patrzę na odsetek, nie na najładniejszy artefakt.
Wyniki z widokiem stabilności są na benchmark.refio.dev.
Dobra, wracam psuć własne testy, zanim zrobi to za mnie model…
0 komentarzy